可直接交付的 AI 训练数据集
175 个 AI 训练数据集,覆盖音频、图片、视频、文本和题库。每个数据集都附样例,按单报价,线下交付。
共 175 个数据集
美国专利转让记录数据集
采集自美国专利转让数据,收录转让相关记录(登记信息、转让主体、受让主体及涉及专利),保留原始记录结构与字段值,未作二次加工。 可用于:专利转让信息检索、主体关系分析、知识产权数据应用开发。
询价
美国专利授权全文数据集
采集自美国专利授权文档,收录授权全文XML记录及技术文本,保留原始文档结构与内容,未作二次加工。 本次样例提供10份授权全文XML文档(demo_01–demo_10),文件格式与字段以样例文件为准。 可用于:专利全文检索、技术研究、数据应用开发。
询价
中国文本商标数据集
采集自中国商标数据的结构化记录,收录商标申请与注册信息,包含注册号/申请号、国际分类、申请日期、公告信息及专用权期限等字段,保留原始字段与字段值,未作二次加工。 可用于:商标记录检索与整理、分类统计与趋势研究、知识产权数据应用开发。
询价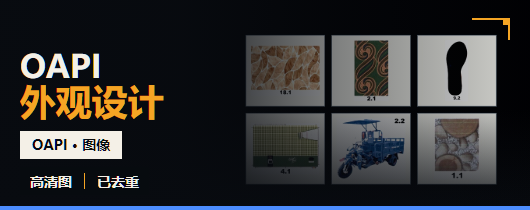
非洲地区(OAPI)外观设计图样数据集
采集自非洲地区(OAPI)的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
非洲地区(ARIPO)外观设计图样数据集
采集自非洲地区(ARIPO)的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
阿根廷图样数据集
采集自阿根廷的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
阿尔及利亚图样数据集
采集自阿尔及利亚的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
阿塞拜疆图样数据集
采集自阿塞拜疆的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
越南外观设计图样数据集
采集自越南的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
越南图样数据集
采集自越南的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
西班牙图样数据集
采集自西班牙的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
葡萄牙图样数据集
采集自葡萄牙的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
芬兰图样数据集
采集自芬兰的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
美国图形商标数据集
采集自美国的商标数据,收录商标图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
罗马尼亚图样数据集
采集自罗马尼亚的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
爱尔兰图样数据集
采集自爱尔兰的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
格鲁吉亚图样数据集
采集自格鲁吉亚的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
柬埔寨图样数据集
采集自柬埔寨的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
斯洛伐克图样数据集
采集自斯洛伐克的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
捷克图样数据集
采集自捷克的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
意大利图样数据集
采集自意大利的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
希腊图样数据集
采集自希腊的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
巴西外观设计图样数据集
采集自巴西的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
奥地利图样数据集
采集自奥地利的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
印度外观设计图样数据集
采集自印度的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
印度商标公报图样数据集
采集自印度的商标数据,收录商标图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
南非外观设计图样数据集
采集自南非的外观设计数据,收录外观设计图样文件,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
北马其顿图样数据集
采集自北马其顿的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
克罗地亚图样数据集
采集自克罗地亚的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
乌克兰图样数据集
采集自乌克兰的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
丹麦图样数据集
采集自丹麦的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
中国香港图样数据集
采集自中国香港的图样数据文件,收录图样类图像,保留原图与文件编码,未作二次加工。 可用于:图样展示与资料整理、图像索引与归档、视觉检索与比对研究、图像处理算法训练、知识产权数据应用开发。
询价
中国图形商标数据集
采集自中国商标数据的图形商标图样文件,收录商标申请与注册中的图形标识图像,保留图样原貌与文件编码,未作二次加工。 可用于:图形商标图样展示与资料整理、图像索引与归档、视觉检索与近似商标比对研究、图像处理算法训练、知识产权数据应用开发。
询价
办公生活教育Agentic轨迹数据集
采集来自线上真实发生的agent交互信息,每条记录完整保留了agent的工作过程:系统提示词、多轮对话、工具定义、工具调用与参数、工具返回结果,以及模型的最终答复。覆盖 Anthropic、OpenAI 、Google、DeepSeek 、智谱等厂商主流AI模型,任务类型覆盖Shell命令执行、代码编辑闭环、检索与网页抓取、浏览器自动化、多智能体编排和纯对…
询价
双音轨AI对话实拍视频数据集
收录真实用户手持手机与AI进行交互的竖屏双音轨视频,覆盖餐厅点餐、咖啡消费、办公资料查看等生活与工作场景。视频记录人物操作、手机屏幕交互、环境画面及音频信息,呈现用户在真实场景中使用 AI 的连续过程。 数据可用于多模态交互理解、AI Agent场景识别、手机操作行为分析、音视频对齐、人机交互研究和视觉语言模型训练。样例包括点餐、购买咖啡、查看资料等典型任…
询价
多国电影电视剧视频元数据集
收录美、英、日、韩等30多个国家和地区的电影及电视剧视频文件数据,覆盖作品基础信息、文件定位信息、视频技术参数、时长信息以及UTC更新时间。可用于影视资源目录建设、国家与地区分布分析、分辨率与时长筛选,以及视频处理任务的数据准备。 点击下载查询电影、电视剧列表:
规模:6151条
询价
宠物叫声情绪标注数据集
本数据集收录猫、狗的叫声音频,并提供对应的情绪及行为状态标签,适用于宠物声音分类、情绪标签预测、动物声音事件识别及宠物交互产品的算法研究与开发。音频已切分为短片段,便于按样本进行检索、处理和模型训练。 数据集内容如下: 动物类别:包含猫、狗,标注中记录对应动物类型。 情绪状态标签:样例涵盖开心、兴奋、害怕、恐惧不安、警告、期待、讨好、享受、乖巧、祈求等;单…
规模:50000+
$0.88/ 条
中文普通话口语音频数据库
中文普通话口语语音数据库共566小时,单通道188.7小时,录音语言为中文。共邀请219名来自中国北方地区发音人参与录制。录制过程为录音棚,录音人通过高保真麦克风,以自由说的形式进行录制。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在96%以上。此数据库可用于声纹识别、语音识别等研究。
规模:566小时
询价
直播方言语音数据库
方言语音数据库,共157614小时。数据主要来自抖音、快手、好看、西瓜视频、哔哩哔哩、爱奇艺等视频平台,为网上公开音视频。方言覆盖北京、香港、西藏、四川等29个地区。采样率16000Hz,比特率16bit,来自7000多个博主。
规模:166114小时
询价
智能家居语音数据-中文
智能家居语音数据库共1852小时。录音语言,中文;录音地区,中国。录音文本包含主流家居场景智能控制、命令等11个分类。以中国北方口音区域为主邀请646名发音人参与录制。录制过程在真实家居环境中,模拟智能家居电器及应用产品使用情况,设置7个录音位。其中5个为高保真麦克风(44.1kHz,16bit,每个麦克风录制时长在217~284小时之间)、1个iOS系统…
规模:1852小时
询价
智能驾舱人机交互语音数据集-燃油车
智能驾舱人机交互语音数据集共 613 小时。录音语言,中文;录音地区,中国。录音文本包含主流车载场景智能控制、命令等10个分类。以中国北方口音区域为主邀请300名发音人参与录制。录制过程在真实车载环境中,模拟自动驾驶点位,使用4个高保真麦克风(44.1kHz,16bit,122小时)与一部手机(16kHz,16bit,124小时)进行录制。此数据库经过专业…
规模:613小时
询价
中英文唤醒词语音数据库
database contains 1,561.12 hours speech data, including 3,936,003 wake-upwords speech files.Database language: Chinese and English ◎Recording area: China ◎Wake-up words for…
规模:1561.12小时
询价
中文普通话语音数据
中文普通话语音数据库共3002小时。录音文本涉及智能家居、无人驾驶、工业生产等15个领域。邀请2000名来自中国不同口音区域发音人参与录制。录制过程在安静室内环境中,同时使用3种不同设备:高保真麦克风(44.1kHz,16bit,999.7H);Android系统手机(16kHz,16bit,1000.7H);iOS系统手机(16kHz,16bit,100…
规模:3002小时
询价
中文普通话语音数据合成数据
中文普通话语音合成数据库共654小时65.7万条。录音文本涉及智能家居、无人驾驶、工业生产等15个领域。邀请1928名来自中国不同口音区域发音人参与录制。录制过程在安静室内环境中,使用高保真麦克风(44.1kHz,16bit)。TTS0006的音频数据来自和数据库。此数据库经过专业语音校对人员对数据做了拼音和声调的转写标注,并通过严格质量检验,文本准确率在…
规模:654小时
询价
智能家居语音数据-英文
智能家居语音数据库共315小时。录音语言,英语;录音地区,美国。录音文本包含主流家居场景智能控制、影音娱乐、唤醒词、自由文本。邀请207名美国本土发音人参与录制。录制过程在真实家居环境中,模拟智能家居电器及应用产品为录音位,使用4个高保真麦克风(44.1kHz,16bit)同时进行录制。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在…
规模:315小时
询价
智能驾舱语音交互数据集
智能驾舱语音交互数据集共计3164小时。录音语言为中文,录音地区为中国,共邀请260名录音人,年龄段为7-55岁,均在真实理想one车载环境内录制完成。此数据库录音内容包含朗读(561H)、对话(2163H)和车载噪声(440H)三类,设备包含三类,共计11个点位:近讲为头戴(48kHz,16bit,210H),车机(16kHz,16bit,824H,4拾…
规模:3164小时
询价
远场声纹语音数据
语音数据库共20253小时。录音语言为中文;录音地区为中国。共邀请511名录音人,每人在不同日期分别录制3次语音,时间跨度为7-25天。录音人年龄段为17-66岁,此数据库可用于声纹识别、语音识别等研究。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:20253小时
询价
阿拉伯语语音数据库
阿拉伯语语音数据库,共899小时,448611句。采样率16000Hz,比特率16bit。共邀请1348名发音人通过手机在安静环境下进行录制。发音人主要来自阿尔及利亚、摩洛哥、沙特和埃及。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:899小时
询价
俄语语音数据库
俄语语音数据库,共1279小时,517548句。采样率16000Hz,比特率16bit。共邀请939名发音人通过手机在安静环境下进行录制。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:1279小时
询价
哈萨克语语音数据库
哈萨克语语音数据库,共1275小时,446250句。采样率16000Hz,比特率16bit。共邀请736名发音人通过手机在安静环境下进行录制。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:1275小时
询价
老人中文普通话数据
老年人中文语音数据库共793小时。录音语言,中文;录音地区,中国。录音文本包含智能控制词、POI等12个分类。邀请503名55岁及以上老年人参与录制。录制过程在安静室内环境中,同时使用3种不同设备:高保真麦克风(44.1kHz,16bit,266H);Android系统手机(16kHz,16bit,264H);iOS系统手机(16kHz,16bit,263…
规模:793小时
询价
模型生成中文情感合成语音数据库
模型生成中文情感合成语音数据库共计46.2万条,共计92个发音人数据。合成引擎来自讯飞、火山、阿里和微软:讯飞(16kHz,16bit);火山(24kHz,16bit);阿里(16kHz/24kHz/48kHz,16bit);微软(48kHz,16bit)。
规模:46.2万条
询价
智能驾舱人机交互语音数据集-新能源车
智能驾舱人机交互语音数据集共10854小时。录音语言,中文;录音地区,中国。录音文本包含主流车载场景智能控制、命令词等5个分类。文本设计包含正常语速和快速语速。邀请了来自中国不同口音区域的2076名发音人参与录制。录制过程在真实车载环境中,模拟自动驾驶点位,使用7个高保真麦克风(16kHz,16bit,1207H*7个)、一部安卓系统手机(16kHz,16…
规模:10854小时
询价
泰语语音数据集
泰语语音数据库,共100小时。采样率16000Hz,比特率16bit。发音人为泰语母语者,年龄范围为7-70岁。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:100小时
询价
模型生成方言合成语音数据库
模型生成方言合成语音数据库共计910万条,共计36个发音人数据。合成引擎来自讯飞、火山和微软:讯飞(16kHz,16bit);火山(24kHz,16bit);微软(48kHz,16bit)。
规模:910万条
询价
印尼语语音数据集
印尼语语音数据库,共100小时。采样率16000Hz,比特率16bit。发音人为印尼语母语者,年龄范围为7-70岁。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:100小时
询价
粤语方言语音数据库
粤语方言语音数据库共768小时。数据类型包含朗读和对话,其中朗读618.8小时,对话149.4小时。录音语言为粤语;录音地区为中国广州。共邀请2672名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,文本正确率达到95%以上,可用于声纹识别、语音识别等研究。
规模:768小时
询价
四川方言语音数据库
四川方言语音数据库共688小时。数据类型包含朗读和对话,其中朗读341小时,对话347小时。录音语言四川方言;录音地区为中国四川。共邀请1729名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,文本正确率达到95%以上,可用于声纹识别、语音识别等研究。
规模:1285小时
询价
上海方言语音数据库
上海方言语音数据库共340小时。数据类型包含朗读和对话,其中朗读174小时,对话166小时。录音语言为上海方言;录音地区为中国上海。共邀请724名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,文本准确率达到95%以上,可用于声纹识别、语音识别等研究。
规模:340小时
询价
越南语语音数据集
越南语语音数据库,共100小时。采样率16000Hz,比特率16bit。发音人为来自河内和胡志明市的越南语母语者,年龄范围为7-70岁。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:100小时
询价
会议数据
会议对话语音数据库共639场会议,共381有效小时。录音语言,中文;录音地区,中国。会议内容覆盖商务、生活、工作等。以中国北方口音区域为主邀请162名发音人参与录制。录制过程在真实会议环境中,录制设备包括头戴式麦克风、1个真实会议语音记录设备、高保真麦克风、Android系统平板、iOS手机、16麦面阵和16麦圆型麦克风阵列。音频存储格式为16kHz,16…
规模:666小时
询价
合成语音数据库
合成语音数据库,共300000小时。数据主要来自喜马拉雅、云听、荔枝FM、有声图书以及腾讯音乐等有声平台。领域覆盖儿童、健康、热点、历史、商业、生活以及娱乐等多领域。采样率16000Hz,比特率16bit。该数据库来自网络公开有声平台,经过技术清洗,达到符合语音合成音频质量,清洗步骤如下:数据命名规则:
规模:300000小时
询价
声纹语音数据
语音数据库共671小时。录音语言为中文;录音地区为中国。共邀请7986名来自中国不同口音区域发言人参与录制。每人5分钟时长,使用手机采集语音,采样率为16000Hz,比特率为16bit。2000人采集环境为车内,646人采集环境为家居环境,5340人采集环境为安静录音室。此数据库可用于声纹识别等研究。
规模:671小时
询价
1300人声纹语音数据
语音数据库共602小时。录音语言为中文;录音地区为中国。共邀请1300名来自中国不同口音区域的发言人,每人在不同日期的早、午、晚三个时段分别录制3次语音,单人录制时间跨度为7-78天。录音人的年龄段为9-65岁,使用手机录制语音,覆盖常用手机机型。此数据库可用于声纹识别等研究。1300人声纹三次录制时间间隔表,其中t1表示第二次和第一次录制的时间间隔,t2…
规模:602小时
询价
模型生成英文合成语音数据库
模型生成英文合成语音数据库共计151万条,61个发音人数据。合成引擎来自火山、微软和openai:火山(24kHz,16bit);微软(48kHz,16bit);openai(24kHz,32bit)。
规模:151万条
询价
中文多人合成数据库
中文多人语音合成数据库共12.76小时,12519条语音。录音语言,中文;录音地区,中国。邀请41名专业发音人在专业录音棚进行录制。录音设备为高保真,音频采样率为48kHz,比特率16bit。此数据库经过专业语音校对人员转写标注,标注包含字、拼音以及韵律,并通过严格质量检验,文本正确率达到99%。
规模:12.76小时
询价
情感语音合成数据库
中文情感语音合成数据库共40小时。录音语言,中文;录音地区,中国。以中国北方口音区域为主邀请109名发音人参与录制。其中100名录音人分别录制悲伤、愤怒、恐惧、快乐、中性5种情绪,9人分别录制悲伤、愤怒、快乐、惊讶和中性共5种情感。安静录音室录制,设备覆盖高保真,音频采样率为48kHz&44.1kHz & 16kHz,比特率16bit。此数据库经过专业语音…
规模:40小时
询价
代码数据集
代码数据集,包含6种编程语言,共计9680258道代码题。编程语言覆盖C、C++、Java、JavaScript、Python、SQL。编程领域覆盖系统调用、内核模块、设备驱动、网络协议实现、并发处理以及内存管理等。数据内容包含编号、编程题目、难度评估、题解、答案、测试用例、编程语言等元信息。
规模:9680258题
询价
新闻文本数据集
新闻文本数据集,包含6个网站,共计3674341167条文本。网站覆盖新浪网、澎湃网、人民网、搜狐、网易以及新华网,采集范围覆盖信源网站全量信息,采集范围覆盖2014年至2025年底,数据内容包含标题、内容、网站名称、网站域名、文章链接、图片链接等元信息。
规模:3674341167条
询价
客家方言数据库
客家方言语音数据库共513小时。录音语言为客家方言;录音地区为中国梅州。共邀请411名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,字正确率达到96%以上,可用于声纹识别、语音识别等研究。
规模:513小时
询价
听障语音数据库
听障语音数据库,共315人,341小时。邀请母语为中文的听障人群录制,采样率16000Hz,比特率16bit。数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在97%以上。
规模:341小时
询价
青岛方言语音数据库
青岛方言语音数据库共309小时。录音语言为河南方言;录音地区为中国河南。共邀请62名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,字正确率达到96%以上,可用于声纹识别、语音识别等研究。
规模:309小时
询价
济南方言语音数据库
济南方言语音数据库共208小时。录音语言为济南方言;录音地区为中国济南。共邀请336名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,字正确率达到96%以上,可用于声纹识别、语音识别等研究。
规模:208小时
询价
河南方言语音数据库
河南方言语音数据库共450小时。录音语言为河南方言;录音地区为中国河南。共邀请262名录音人,在安静环境下使用手机进行录制。此数据库经过专业校对,字正确率达到96%以上,可用于声纹识别、语音识别等研究。
规模:737小时
询价
台湾普通话语音数据库
台湾普通话语音数据库,共720.8小时。采样率16000Hz,比特率16bit。数据为网络数据,包含健康、影视、旅游、科技等11个领域,该数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在96%以上。
规模:720.8小时
询价
泰语语音数据库
泰语语音数据库,共530小时。采样率16000Hz,比特率16bit。发音人为泰语母语者,手持收集安静环境下录制,年龄18-60,主要领域为金融、体育、科技、文化娱乐、新闻以及日常生活用语。经过专业语音校对人员转写标注,并通过严格质量检验,文本句正确率在95%以上。
规模:530小时
询价
越南语语音数据库
越南语语音数据库,共521小时。采样率16000Hz,比特率16bit。发音人为越南语母语者,年龄范围为14-51岁。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:521小时
询价
远场语音助手语音数据库
远场语音助手语音数据库共6200小时,邀请450名来自中国南北方区域发言人参与,以北方为主。录音语言,中文;录音地区,中国。录音文本内容为语音助手交互内容。录制过程在真实家居环境中,客厅、卧室、厨房分别设置5、4、3个录音位,录制使用圆形16路PDM麦克风阵列录音板(16KHz、16bit;6083H)做远讲拾音和高保真麦克风做近讲拾音(44.1KHz、1…
规模:6200小时
询价
陕西方言语音数据库
陕西方言语音数据库共738小时。录音语言为陕西方言;录音地区为中国。共邀请8356名录音人,在安静环境下使用手机电话呼叫基站录音。数据经过专业校准,文本正确率达到97%以上,此数据库可用于声纹识别、语音识别等研究。
规模:738小时
询价
中英混读语音数据
语音数据库共1200小时。录音语言,中文、英文;录音地区,中国。采样率16Khz,比特率16bit。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率97%以上。
规模:1200小时
询价
家居场景语控词语音数据库
家居场景语控词语音数据库,共邀请399人在安静环境下通过高保真麦克风进行录制。拾音点位共7个,每个点位拾音80.78小时,共565小时,采样率48kHz,比特率16bit。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:565小时
询价
多信道数字串语音数据库
多信道数字串语音数据库,共349小时,300966句。录音人在安静室内通过手机或者高保真录制。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:349小时
询价
大会数据
会议演讲音频数据库录音时长1459小时,音频来自互联网会议,为真实会场的中控台录音,音频采样率为16kHz,16bit。录音文本涉及科技、金融、教育等16个领域。数据经过专业语音校对人员转写标注,并通过严格质量检验,此数据库文本正确率在97%以上。
规模:1459小时
询价
印地语语音数据
语音数据库共568小时。录音语言,印地语。录音地区,印度。录音文本涉及教育、科技、娱乐、健康等10个领域。580名来自印度不同区域的发言人参与录制。录制过程在安静室内环境中,使用手机(16kHz,16bit)进行录制。经过专业语音校对人员转写标注,并通过严格质量检验,此数据库文本正确率在95%以上。
规模:568小时
询价
中国人说英语语音数据集
中国人说英语语音数据库,共649小时,516051句。采样率16000Hz,比特率16bit。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:649小时
询价
成人英语语音数据
美国英语语音数据库,共987小时。采样率16000Hz,比特率16bit。发言人主要来自加利福尼亚州、纽约州、华盛顿州和俄勒冈州。经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:987小时
询价
中国儿童说英语语音数据
儿童语音数据库共1709小时。录音语言,英文;录音地区,中国。采样率16000Hz,比特率16bit。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:1709小时
询价
低幼儿童语音数据-中文
儿童语音数据库共171小时。录音语言,中文;录音地区,中国。邀请1117名来自中国不同口音区域发音人参与录制。录制过程在安静室内环境中,使用手机(16kHz,16bit)进行录制。此数据库经过专业语音校对人员转写标注,并通过严格质量检验,文本正确率在95%以上。
规模:171小时
询价
智能机器人语音数据
智能机器人语音数据库共23小时。录音语言,中文;录音地区,中国。录音文本为机器人智能控制文本,每人11句。以中国北方口音区域为主邀请646名发音人参与录制。录制过程在真实家居环境中,模拟智能家居电器及应用产品使用情况,设置7个录音位。其中5个为高保真麦克风(44.1kHz,16bit)、1个为iOS系统手机(16kHz,16bit)与1个Android系统…
规模:23小时
询价
口音对话语音数据库
口音对话语音数据库共1258小时,录音语言为中文。共邀请1493名来自中国不同口音区域发音人参与录制。录制过程为安静室内环境,录音人通过手机,以自然对话形式进行录制。此数据库可用于声纹识别、语音识别等研究。数据经过专业语音校对人员转写标注,并通过严格质量检验,此数据库文本正确率在96%以上。
规模:1258小时
询价
中文普通话语音数据库
中文普通话语音数据库的语音时长为1000小时,其中718小时来自[ZH-CN],282小时来自[ZH-CN]。录音文本涉及唤醒词、语音控制词、智能家居、无人驾驶、工业生产等12个领域。录制过程在安静室内环境中,同时使用3种不同设备:高保真麦克风(44.1kHz,16bit);Android系统手机(16kHz,16bit);iOS系统手机(16kHz,16…
规模:1000小时
询价
婴幼儿啼哭音频数据库
婴幼儿啼哭音频数据库共68小时,2549条音频。录音地区:中国。参与录制儿童人数为544人。录制过程为安静室内。录制设备覆盖高保真、安卓系统手机、iOS系统手机,音频采样率16kHz,比特率16bit。本数据库可作为声纹/语音识别、信号检测等研究用途。
规模:68小时
询价
糖尿病视网膜病变临床诊疗数据集
本数据集为以糖尿病及其视网膜病变为核心队列的住院患者结构化电子病历(EHR)数据集,共1,000例真实住院病案。患者100%含糖尿病诊断、≥99%含视网膜相关诊断,主诊断覆盖玻璃体积血(32.3%)、糖尿病性视网膜病变、黄斑囊样水肿、老年性白内障、新生血管性青光眼及糖尿病肾病等DR常见共病谱系,来自眼科、内分泌科、肾内科等科室,为眼底病AI研究与医疗大数据…
规模:1000例
询价
口音英语ASR语料库
覆盖泰国英语、印尼英语、马来英语等东南亚口音英语,信噪比≥10dB,字准率97%。音频含短对话(日常交流)、长音频(访谈/广播),文本精准对齐,助力多口音英语语音识别、跨境客服、本地化AI研发。
规模:100小时
询价
越南语小语种ASR语料
精选越南语真实场景音频(含短音频+长音频),信噪比≥10dB,字准率97%。覆盖越南语日常、访谈、影视对白等场景,音频+文本一一对应,支撑越南语语音识别、跨境直播、本地化工具开发。 短音频时长<1 Min, 长音频时长 >1 min。
规模:100小时
询价
泰语小语种ASR语料库
精选泰语真实场景音频(含短音频+长音频),信噪比≥10dB,字准率97%。覆盖泰语日常、综艺、新闻等场景,音频+文本严格对齐,为泰语语音识别、智能客服、内容审核提供可靠数据。 短音频时长<1 Min, 长音频时长 >1 min。
规模:800小时
询价
马来语小语种ASR语料库
精选马来语真实场景音频(含短音频+长音频),信噪比≥10dB,字准率97%。覆盖日常交流、文化节目、生活vlog等场景,音频+文本精准对齐,助力马来语语音识别、本地化AI产品研发。 短音频时长<1 Min, 长音频时长 >1 min。
规模:500小时
询价
印尼语小语种ASR语料库
精选印尼语真实场景音频(含短音频+长音频),信噪比≥10dB,字准率97%。覆盖日常对话、访谈、广播等场景,音频+文本一一对应,直接支撑印尼语语音识别、语音合成、多语言大模型训练。 短音频时长<1 Min, 长音频时长 >1 min。
规模:3200小时
询价
Claude Opus真实业务操作日志数据集
本数据集采集自企业内部近 600 人全职能员工真实业务落地场景,完整沉淀 Claude Opus 大模型全链路操作日志,覆盖研发、产品、法务、运营、财务、项目管理等多岗位日常 AI 使用行为。数据来源于内部 AI 业务平台的线上真实 API 调用、Agent 工具交互、多轮长对话、批量文档处理全流程,所有原始数据均完成隐私脱敏处理,去除员工个人标识、企业涉…
规模:2000轮
$19.41/ 轮
多场景手部动作视频集
全部样本均包含清晰完整手部操作动作,覆盖多品类设备维修全过程,聚焦手部拆装、调试、检测、更换、紧固等实操手势,画面无重度手部遮挡、动作时序完整 下面是meta信息
规模:50万条
$0.59/ 条
X(原 Twitter)帖子推文数据集
该数据为 X(原 Twitter)平台单条推文的爬虫采集结构化数据,分为外层推文主体信息、嵌套发布者用户信息两大模块,全部使用时间戳、数字、布尔、字符串、JSON 数组存储数据,用于完整记录推文内容、发布账号、互动数据、媒体资源、采集时间等维度信息。
规模:10亿条
$3.89/ 千条
TikTok元信息数据集
基础信息:tiktok短视频、上传时间、时长、语种等; 播放数据:播放次数、点赞数、评论数等; 画面参数:分辨率,帧,比例等; 音视频编码:编码、声道,采样率; 账号信息:上传频道,粉丝数; 素材属性:处出、时间等。
规模:900亿条
$1.95/ 千条
英语全类图片OCR数据集
本数据涵盖带有英语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 下面文件为sft数据
规模:9000张
$0.88/ 张
印尼语全类图片OCR数据集
本数据涵盖带有印尼语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 下面文件为sft数据
规模:5000张
$0.88/ 张
意大利语全类图片OCR数据集
本数据涵盖带有意大利语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 下面文件为sft数据
规模:3500张
$0.88/ 张
西班牙语全类图片OCR数据集
本数据涵盖带有西班牙语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 以下文件时sft数据
规模:4000张
$0.88/ 张
日语全类图片OCR数据集
本数据涵盖带有日语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 一下是sft数据
规模:5000张
$0.88/ 张
葡萄牙语全类图片OCR数据集
本数据涵盖带有葡萄牙语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。 一下是sft数据
规模:4000张
$0.88/ 张
汉语全类图片OCR数据集
本数据涵盖带有汉语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。
规模:3000张
$0.88/ 张
韩语全类图片OCR数据集
本数据涵盖带有韩语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。
规模:5000张
$0.88/ 张
法语全类图片OCR数据集
本数据库涵盖带有法语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。
规模:4000张
$0.88/ 张
俄语全类图片OCR数据集
本数据涵盖带有俄语的物品图片,包含:包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、名片、商品包装、书籍、小票、宣传栏、杂志、指示牌。 有标注信息
规模:5000张
$0.88/ 张
德语全类图片OCR数据集
本数据库涵盖带有德语的物品图片,包含:PPT、包装、报刊、表格、菜单、车票、地图、店铺名、飞机票、广告牌、海报、横幅、火车票、卡片、名片、商品包装、书籍、小票、宣传栏、艺术字、杂志、指示牌。
规模:4000张
$0.88/ 张
小学手写试卷OCR数据集
本数据库通过不同用户的手机拍摄,主要收录小学语文与英语的教辅资料图片,聚焦小学语文重点汉字、古诗意象及英语高频词汇、情景对话。 1、采集学科: 语文(42725张)、英文(13093张) 已经脱敏,手机高清拍摄,用于OCR识别
规模:50000张
$1.95/ 张
YouTube音乐音频集
YouTube音乐数据 包含meta信息 { "title": "SUBEME LA RADIO REMIX", "artists": [ "Enrique Iglesias", "CNCO" ], "uploader": "Enrique Iglesias" } 歌词信息 Súbeme la radio Tra-tráeme el alcohol…
规模:5000W条
$0.01/ 首
YouTube视频元信息数据集(可定制)
提供条件进行筛选之后的meta信息 只有上面的字段为条件 基础信息:YouTube短视频、上传时间、时长、语种等; 播放数据:播放次数、点赞数、评论数等; 画面参数:分辨率,帧,比例等; 音视频编码:编码、声道,采样率; 账号信息:上传频道,粉丝数; 素材属性:处出、时间等。
规模:50亿条
$5.83/ 千条
YouTube视频元信息数据集
基础信息:YouTube短视频、上传时间、时长、语种等; 播放数据:播放次数、点赞数、评论数等; 画面参数:分辨率,帧,比例等; 音视频编码:编码、声道,采样率; 账号信息:上传频道,粉丝数; 素材属性:处出、时间等。
规模:50亿条
$1.95/ 千条
职业考试题库数据集
包含58个学科全覆盖职业考试题库总计900w道题目 分类清晰如下: 一、交通工程类考试 公路工程、地铁相关、航空从业、船舶航运、铁路系统 二、建筑工程类考试 八大员、建筑三类人员、建筑技能考核、建筑资格证书、水利工程 三、安全特种作业类考试 冶金(有色)生产安全作业、危险化学品安全作业、烟花爆竹安全作业、煤矿安全作业、金属非金属矿山作业、石油天然气安全作业…
规模:900万题
$0.16/ 题
大学题库数据集
50 万 + 高校专业题库,覆盖全门类学科:体育学、军事学、农学、化学、化工、医学、历史学、地理学、建筑学、政治学、教育学、数学、机械工程、材料科学、车辆工程、法学、物流管理、物理学、环境科学、生物学、管理学、经济学、统计学、艺术学、外国语言文学、计算机科学与技术、食品科学
规模:50万题
$0.16/ 题
打斗场景视频集
1.时长覆盖5-15s,单镜头和多镜头数据 2.有完整的故事情节 3.包含复杂的动作 4.影视级别的运镜 5、年份:2010后发行的电影 6、分辨率:1080P无字幕和水印
规模:20万条
$0.98/ 条
Ego工厂流水线视频集
头戴式相机采集工人第一人称(自我中心)工业视频 无存量数据 记录产线装配、质检、物料操作全流程,聚焦手物交互、工序动作、车间复杂环境,用于工业行为识别、机器人模仿学习、工人安全辅助、工序时序分割等任务。
规模:月产能5000小时
$15.53/ 小时